Windows Explorer كان بيكراش وأنا بختبر الإيماءات على التابلت. وسّعنا المنطقة اللي بنتجاهل فيها اللمس عند حواف الشاشة. منعنا أحداث السكرول من الوصول لنوافذ تابعة للـ shell. Explorer فضل يكراش.
كنت ببني PromptCast، أداة بتعرض سطح مكتب Windows على تابلت Android وبتعكس الصورة عشان زجاج التيليبرومتر. كنت عايز أقرا ملاحظاتي في مكالمة وأنا باصص للكاميرا. المشروع كبر وبقى فيه لمس وميكروفون وإملاء. الـ Agent كتب تقريبًا كل التنفيذ. أنا وجّهت الشغل واختبرته على أجهزتي.
أغلب خبرتي المهنية في تطوير الويب. الشغل مع Agent بيكتب الكود خلّى بناء PromptCast أسهل وأسرع بكتير.
خبرتي كمهندس بتضيف إيه لما الـ Agent يكتب التنفيذ؟
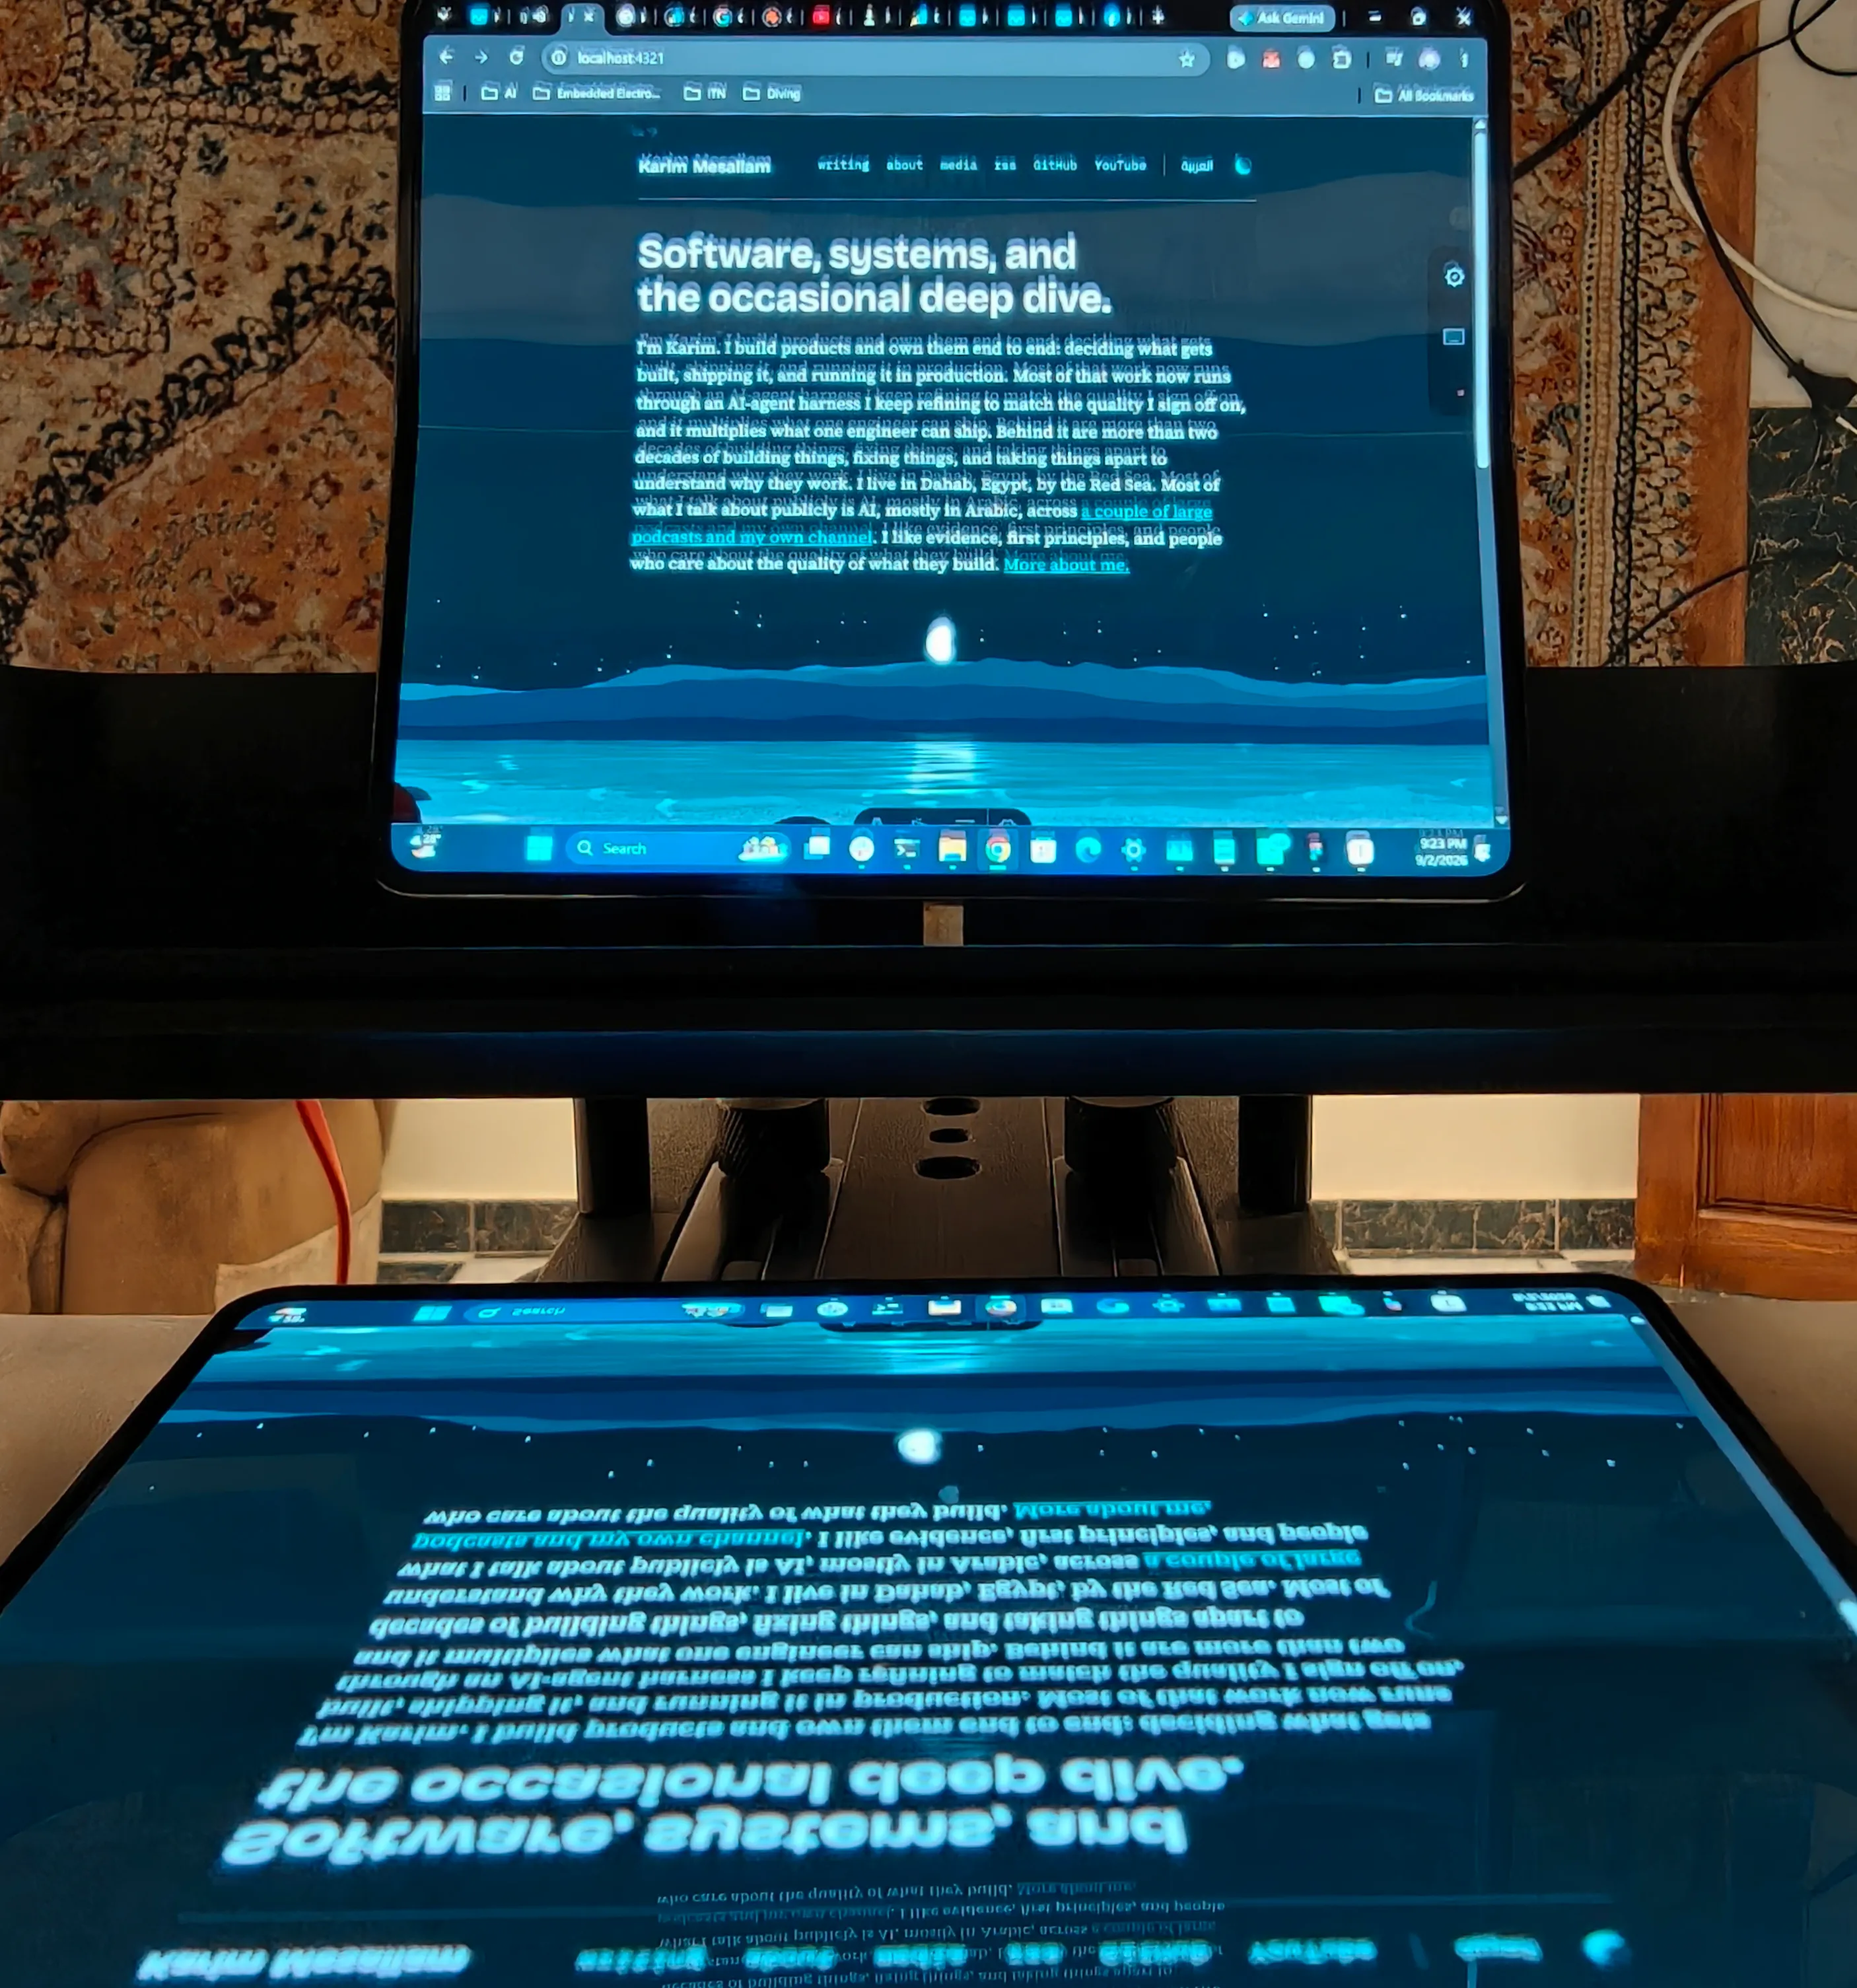
النسخة الأولى اتجمعت في يومين تقريبًا. الجزء ده كان ممتع. لكن إن Windows Explorer يكراش وأنا بستخدمها كان سبب إني أهدّي وأفحص اللي بيحصل.
نظرية اللمس كانت معقولة: الكراش كان بيحصل كتير وأنا بسحب قرب الحواف. بس التعديلات المبنية على النظرية دي ما وقفتوش. كنت محتاج أشوف حاجة تقول لنا نفحص إيه بعد كده.
ممكن أصيغ الطلب بالشكل ده:
تعديلات اللمس ما وقفتش الكراش.

سجّل تطبيقنا بيعمل إيه قبل ما explorer يعيد التشغيل.
احفظ الأحداث اللي حوالين كل كراش عشان نقارنها قبل ما نغيّر أي حاجة تانية.
طلبت سجل متجدد لأحداث الإدخال، وطريقة نرصد بيها إعادة تشغيل Explorer. السجلين اللي اتحفظوا بعد كده ورّوا إيماءات عادية. والاتنين ورّوا كمان إن تطبيقنا أخفى كيبورد اللمس بتاع Windows قبل الكراش بحوالي ثلاث ثواني.
خاصية الكيبورد عندنا كانت بتنهي العملية بتاعته عشان تظهر الكيبورد بتاعها. غيّرنا ده عشان نقفل نافذة الكيبورد ونسيب العملية شغّالة. كراشات Explorer وقفت في اختباراتي.
السجل غيّر الإصلاح اللي جرّبناه بعد كده
النظرية الأولى
- إيماءات اللمس هي السببشكّينا فيها من توقيت الكراش
- نغيّر معالجة اللمسنوسّع المنطقة الميتة ونمنع السكرول
- Explorer لسه بيكراشالتعديلات ما حلّتش المشكلة
الملاحظة اللي فادتنا
- نسجّل الأحداث اللي قبلهنقارن السجلات المحفوظة
- عملية الكيبورد انتهتقبل الكراش في السجلين
- نقفل النافذة بسنسيب العملية شغّالة
- الكراش وقف في الاختبارنتحقق على الأجهزة الفعلية
الـ Agent بنى أدوات التسجيل وساعد في تحليل المخرجات. ونفّذ الإصلاح كمان. مساهمتي كانت إني ألاحظ إن الدليل اللي معانا مش بيجاوب على السؤال. كنت أقدر أفضل أطلب تعديل تاني، أو أطلب طريقة تورّينا أكتر عن العطل.
مع ميكروفون PromptCast، احتجت أغيّر طريقة جمع الدليل برضه. الطقطقة فضلت موجودة بعد حوالي ست محاولات. طلبت من Fable، الـ Agent اللي بيكتب الكود، يبطّل تخمين ويبني واجهة اختبار أقدر أسجّل بيها صوتي عبر PromptCast، من ميكروفون التابلت لـ Windows، عشان نحلّله.
قلت إني سامع الطقطقات بفواصل متساوية. Fable فحص التسجيل واتأكد من ملاحظتي. ده خلّانا نستبعد الاتصال كسبب: مشاكل الشبكة كانت هتعمل فجوات مش منتظمة. الفواصل المتساوية وجّهتنا لاحتمال مشكلة في الـ clock أو الـ sample rate. حكيت باقي الفحص في مقالة PromptCast.
ده الجزء اللي عايز أتحسّن فيه وأنا بشتغل مع الذكاء الاصطناعي. الـ Agent يقدر يعمل فحص كبير للعطل. أنا محتاج أقدر أحكم إذا كان الفحص ده مفيد، وإذا كانت نتيجته بتجاوب على المشكلة اللي بدأت بيها.
في يونيو 2026، Anthropic حلّلت حوالي 400 ألف جلسة تفاعلية مع Claude Code. البشر عادةً أخدوا أغلب قرارات التخطيط، والـ Agent أخد أغلب قرارات التنفيذ. الخبرة اللي ظهرت في المهمة ارتبطت بجلسات أنجح. الباحثين استنتجوا الخبرة والنجاح من نصوص المحادثات؛ ما كانوش يقدروا يشوفوا إذا كان البرنامج اشتغل بعد كده في الاستخدام الفعلي.
النتيجة دي بتخلّيني مهتم باللي الشخص بيضيفه للمهمة. معرفة الـ framework بتساعد. وكمان فهم اللي مستخدم البرنامج بيحاول يعمله، أو ملاحظة إن القياس مش بيغطّي الجزء اللي بيبوظ في النظام. الـ Agent يقدر يساعدنا نطوّر الفهم ده ونراجعه.
في PromptCast، حتى اتجاه بث الفيديو كان فارق. كنت محتاج Windows يتبعت لـ Android. أداة بتعرض Android على Windows ممكن تدعم عكس الصورة أفقيًا وتفضل بتحل مشكلة تانية. صحّحت الفرق ده في المقالة الأصلية بعد ما بالغت في وصف قدرات أداة موجودة.
وصف الفكرة الأصلية كان ممكن يبقى كده:
عايز أقرا ملاحظاتي في مكالمة وأنا باصص للكاميرا.

استخدم سطح مكتب windows كمصدر، وتابلت android تحت زجاج التيليبرومتر كشاشة.
النص لازم يبقى مقروء في الانعكاس.

شوف إذا كانت فيه أداة موجودة تعمل ده قبل ما تقترح حاجة محتاجين نبنيها.
ده بيوصف الاستخدام والقيود. الـ Agent عنده مساحة يبحث عن الاختيارات ويختار تنفيذ. وأنا عندي حاجة أراجع اقتراحه على أساسها. لو الاقتراح بيبعت الفيديو في الاتجاه الغلط، أقدر أرفضه قبل ما يبقى عندي تطبيق أصلّح أخطاءه.
لما الشغل يبدأ، عايز أوصل بسرعة من نتيجة غير متوقعة لملاحظة نقدر نستفيد منها. طريقة الشغل اللي عايز أتمرّن عليها شكلها كده:
رجّع النتيجة لسياق المهمة
- اوصف النتيجة المطلوبةالاستخدام والقيود وطرق التحقق
- سيب الـ Agent يشتغليفحص وينفّذ ويشغّل الاختبارات
- راجع الدليلالسلوك بيحقق اللي محتاجينه؟
نتيجة غير متوقعة؟خد الدليل الجديد معاك للمحاولة الجاية.
التحقق لازم يوصل للسلوك اللي يهمّنا. بناء تطبيق Android في PromptCast كان بيشغّل اختبارات وحدة لحاجات زي هندسة الكيبورد وتأطير البروتوكول. فحص مشكلة Explorer احتاج سجلات أحداث واختبار على أجهزتي. مشاكل الميكروفون احتاجت تسجيل صوت. كل طريقة جاوبت على سؤال مختلف.
في مشروع تاني، الدليل ممكن يكون استخدام بالكيبورد بدل الماوس، أو حالة قاعدة البيانات بعد إعادة محاولة، أو اختبار تحميل للجزء اللي شاكّين إنه بيبطّأ النظام. الـ Agent يقدر يبني الاختبار. ولسه محتاجين نقرر إذا كان نجاحه بيثبت السلوك اللي المستخدم محتاجه. الاختبارات اللي اتكتبت من نفس الافتراض الغلط اللي اتبنى عليه التنفيذ ممكن تتفق معاه تمامًا.
أدي الـ Agent وصول كفاية عشان يكمّل الشغل ده في بيئة مناسبة. قاعدة بيانات للاختبار ممكن تساعد في الفحص من غير بيانات دخول بيئة التشغيل الفعلية. والتعديل اللي تأثيره أوسع محتاج طريقة مناسبة للنشر والرجوع لو حصلت مشكلة. نطاق التفويض لازم يوضّح الحدود دي.
وعايز أقيس كمان الشغل اللي حوالين أول تعديل. تجارب Microsoft Research الميدانية لقت زيادة حوالي 26% في المهام المكتملة، عبر 4,867 مطوّر. تجربة METR في أوائل 2025 ومتابعتها في فبراير 2026 بيحكوا قصة أعقد: المشاركين الأصليين أخدوا وقت أطول بنسبة 19% مع AI، ومشاكل اختيار المشاركين وقياس الوقت خلت نتيجة المتابعة غير موثوقة. المهام والأدوات اختلفت، والنتائج اختلفت معاها.
أنا ما قستش مقارنة لـ PromptCast. يومين تقريبًا لنسخة أولى بيقولوا لي إمتى قدرت أبدأ أجرّبها. مقارنة مفيدة للإنتاجية هتحسب كمان الفحص والمراجعة والإصلاح اللي احتجتهم عشان أقدر أفضل أستخدمها.
تفويض التنفيذ بيغيّر كمان الفرص اللي عندي عشان أتمرّن. في دراسة عشوائية على 52 مطوّر بيتعلّموا مكتبة Python غير متزامنة ما يعرفوهاش، المجموعة اللي استخدمت AI جابت درجات أقل بـ 4.15 نقطة في تقييم فوري من 27 نقطة. التحسّن في متوسط وقت إنجاز المهمة ما كانش دال إحصائيًا. التجربة قاست الفهم بعد مهمة تعلّم محددة مباشرة.
ده سبب يخلّيني أخصص وقت أفهم تعديل مش مألوف ليا بعد ما يتنفّذ. أطلب من الـ Agent يمشّي معايا في التعديل والدليل اللي بيدعمه:
اشرح لي ليه الإصلاح ده بيشتغل.

ورّيني الكود القديم كان بيعمل إيه، وإيه اللي اتغيّر، وإزاي ده بيعالج العطل.
حدّد الكود المقصود والدليل من الاختبار.

إيه اللي لسه بنفترضه وما اتحققناش منه؟
في إصلاح Explorer، عايز أفهم ليه قفل نافذة مختلف عن إنهاء العملية بتاعتها. أقرا الكود المقصود جنب الشرح، وبعدين أراجع النتيجة اللي الشرح بيقولها على السجلات المحفوظة والاختبار على الأجهزة. لو فيه خطوة مش واضحة، يبقى عندي آلية محددة أدرسها.
حاجة مفيدة أخدها معايا للمهمة الجاية هي السؤال اللي حرّك المهمة دي لقدّام. ممكن يستاهل اختبار، أو ملاحظة جنب الكود، أو skill أستخدمها تاني لو الخطوات بتتكرر. أخليه محدد كفاية عشان مهندس تاني يقدر يعرف إمتى ينطبق.
التابلت لسه تحت الزجاج وأنا بستخدم سطح المكتب. الـ Agent كتب البرنامج اللي خلّى ده ممكن. لما مشكلة جديدة تظهر، عايز أقدر أوصف اللي شفته، وأختار أراقبه فين، وأدي المحاولة الجاية دليل أحسن من اللي كان مع اللي قبلها.